گاهی همهچیز در مانیتورینگ طبیعی به نظر میرسد؛ مصرف CPU بالا نیست، حافظه در محدوده قابل قبول قرار دارد و خبری از Restart شدن Containerها نیست. با این حال، کاربران از کندی سرویس شکایت دارند و نمودارهای P95 و P99 نشان میدهند زمان پاسخگویی افزایش پیدا کرده است.
در چنین شرایطی یکی از مواردی که باید بررسی کنیم، CPU Throttling است.
این مشکل کمی گمراهکننده است؛ چون ممکن است یک Container با وجود مصرف پایین CPU در نمودارها، مرتباً به محدودیت CPU خودش برسد و برای ادامه پردازش منتظر بماند.
برای فهمیدن علت، باید ببینیم Kubernetes چطور محدودیت CPU را اعمال میکند و Linux Kernel هنگام رسیدن یک Container به این محدودیت چه رفتاری دارد.
تفاوت درخواست و محدودیت CPU در Kubernetes چیست؟
قبل از اینکه سراغ جزئیات برویم، بهتر است تفاوت این دو مفهوم را روشن کنیم.
فرض کنید برای یک Container چنین منابعی تعریف کردهایم:
resources:
  requests:
    cpu: "500m"
  limits:
    cpu: "500m"
CPU Request مقداری است که Kubernetes هنگام زمانبندی Pod از آن استفاده میکند. این مقدار در شرایط رقابت بین Workloadها روی سهم نسبی CPU هم تأثیر دارد، اما به معنی اختصاص نیم هسته فیزیکی به Container نیست.
از طرف دیگر، CPU Limit سقف مصرف CPU را مشخص میکند. در Nodeهای لینوکسی، این محدودیت معمولاً از طریق Cgroups و مکانیزم CPU Bandwidth Control در Kernel اعمال میشود.
یک نکته مهم:
اگر برای Container فقط Request تعریف کنیم و Limit نداشته باشیم، معمولاً امکان مصرف بیشتر از مقدار Request وجود دارد؛ البته محدودیتهای احتمالی در سطح Cgroup والد یا خود Node همچنان میتوانند اثرگذار باشند.
پس Request و Limit را نباید بهجای یکدیگر استفاده کنیم. یکی در زمانبندی و سهم نسبی منابع نقش دارد و دیگری مصرف CPU را محدود میکند.
محدودسازی مصرف CPU چگونه اتفاق میافتد؟ (CFS Bandwidth Control)
Linux برای کنترل میزان استفاده گروهی از Processها از CPU، مکانیزمی به نام CFS Bandwidth Control دارد.
در این مکانیزم دو مقدار اصلی اهمیت دارند:
- CPU Quota: مقدار زمانی که یک Cgroup میتواند از CPU استفاده کند.
- CPU Period: بازه زمانیای که Quota در آن محاسبه و دوباره شارژ میشود.
برای مثال فرض کنید:
CPU Period = 100000 microseconds
CPU Quota  = 50000 microseconds
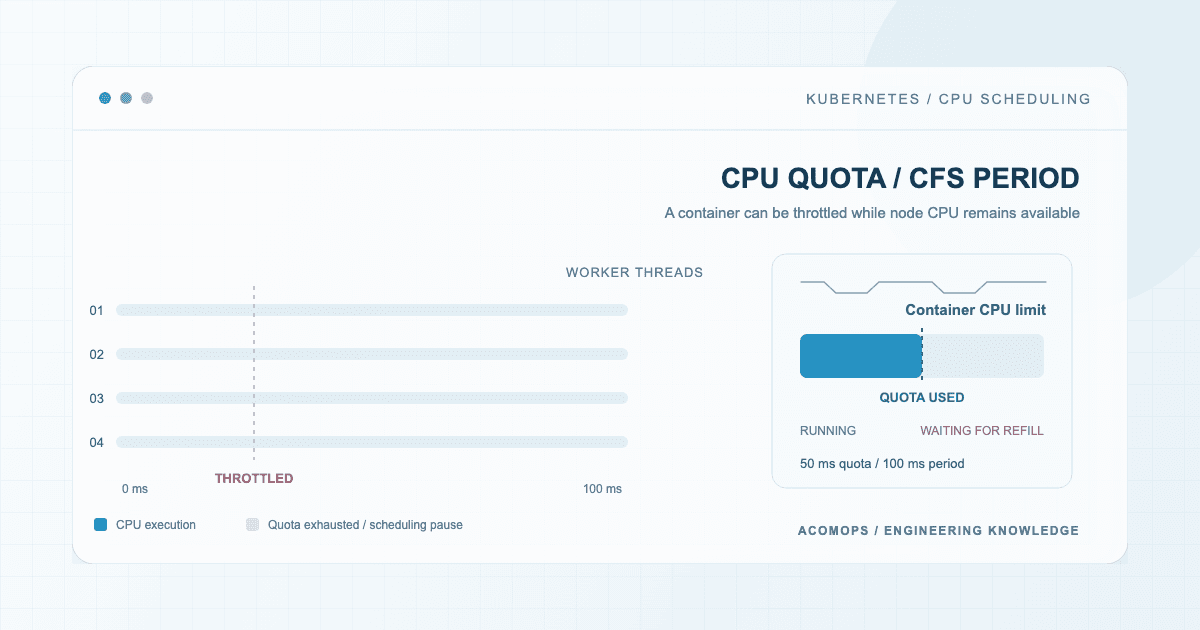
یعنی Container در هر بازه ۱۰۰ میلیثانیهای، مجموعاً ۵۰ میلیثانیه زمان CPU در اختیار دارد.
به زبان ساده، این محدودیت معادل 500m CPU است.
اما اینجا یک نکته مهم وجود دارد: این ۵۰ میلیثانیه لزوماً بهصورت پیوسته و در طول کل ۱۰۰ میلیثانیه مصرف نمیشود.
فرض کنید Application شما چهار Worker Thread دارد و هر چهار Thread بهصورت همزمان روی چهار Core در حال پردازش هستند.
در این شرایط، مجموع زمان مصرفشده توسط چهار Thread میتواند خیلی سریع به Quota برسد:
50ms / 4 = 12.5msیعنی در حدود ۱۲.۵ میلیثانیه زمان واقعی، کل سهمیه ۵۰ میلیثانیهای مصرف شده است.
بعد از تمام شدن Quota، Kernel اجرای Taskهای محدودشده را متوقف میکند تا سهمیه جدید در اختیار Cgroup قرار بگیرد.
به این وضعیت CPU Throttling میگوییم.
این رفتار بهخصوص در Applicationهای چندریسمانی که در بازههای کوتاه به CPU زیادی نیاز دارند، اهمیت پیدا میکند.
محدودیت CPU در کدام لایه اعمال میشود؟ (Cgroups)
Kubernetes خودش مستقیماً اجرای Threadهای Application را متوقف نمیکند. این کار در نهایت توسط Linux Kernel و از طریق Cgroups انجام میشود.
مسیر کلی اعمال محدودیت به این شکل است:
Kubernetes API
      |
      v
Kubelet
      |
      v
Container Runtime
      |
      v
Linux Cgroups
      |
      v
Linux Kernel
برای بررسی این محدودیت باید بدانیم Node از کدام نسخه Cgroups استفاده میکند.
بررسی محدودیت CPU در نسخه اول (Cgroups v1)
مقادیر مربوط به CPU معمولاً از طریق فایلهای زیر قابل بررسی هستند:
cat cpu.cfs_quota_us
cat cpu.cfs_period_us
cat cpu.stat
برای مثال:
cpu.cfs_quota_us: 50000
cpu.cfs_period_us: 100000
این مقادیر نشان میدهند که Cgroup در هر ۱۰۰ میلیثانیه، ۵۰ میلیثانیه CPU Runtime در اختیار دارد.
فایل cpu.stat هم اطلاعاتی درباره وضعیت مصرف و Throttling ارائه میکند.
بررسی محدودیت CPU در نسخه دوم (Cgroups v2)
ساختار کمی متفاوت است. برای بررسی Quota و Period از فایل cpu.max استفاده میکنیم:
cat /sys/fs/cgroup/cpu.maxخروجی نمونه:
50000 100000مقدار اول Quota و مقدار دوم Period است.
اگر Quota نامحدود باشد، مقدار max نمایش داده میشود:
max 100000برای مشاهده آمار CPU هم میتوانیم فایل زیر را بررسی کنیم:
cat /sys/fs/cgroup/cpu.statنمونه خروجی:
usage_usec 12500000
user_usec 11000000
system_usec 1500000
nr_periods 1000
nr_throttled 320
throttled_usec 850000
چند فیلد مهم این خروجی:
- usage_usec: مجموع زمان مصرف CPU
- nr_periods: تعداد دورههای حسابداری CPU
- nr_throttled: تعداد دورههایی که در آنها Throttling اتفاق افتاده است
- throttled_usec: زمان ثبتشده برای Throttling
در Cgroups v1 هم اطلاعات مشابهی در cpu.stat وجود دارد؛ با این تفاوت که نام بعضی فیلدها و واحد اندازهگیری آنها متفاوت است. برای مثال throttled_time در نسخه اول برحسب نانوثانیه گزارش میشود.
بنابراین قبل از اجرای دستورات عیبیابی، حتماً نسخه Cgroups روی Node را مشخص کنید.
چرا محدودیت CPU باعث افزایش زمان پاسخگویی میشود؟ (Latency)
فرض کنید یک سرویس HTTP دارید که چندین درخواست را بهصورت همزمان پردازش میکند.
با افزایش ترافیک، Workerهای بیشتری فعال میشوند و مصرف CPU بالا میرود. اگر این پردازشها خیلی سریع Quota مربوط به Container را مصرف کنند، بخشی از Threadها باید تا زمان دریافت سهمیه جدید منتظر بمانند.
در این فاصله ممکن است درخواستهای در حال پردازش متوقف شوند یا درخواستهای جدید در صف باقی بمانند.
نتیجه میتواند افزایش موارد زیر باشد:
- زمان پاسخگویی درخواستها
- P95 و P99 Latency
- تعداد درخواستهای Timeout شده
- زمان اجرای Jobهای پسزمینه
نکته جالب اینجاست که ممکن است Node هنوز CPU آزاد داشته باشد!
یعنی مشکل لزوماً کمبود CPU در کل سرور نیست؛ ممکن است Container فقط سهمیه خودش را تمام کرده باشد.
اینجاست که تفاوت بین CPU Contention و CPU Quota Exhaustion اهمیت پیدا میکند.
در حالت اول، Workloadها برای استفاده از CPU با یکدیگر رقابت میکنند. در حالت دوم، Container به محدودیت Quota خودش رسیده است.
البته این دو وضعیت میتوانند همزمان هم اتفاق بیفتند.
چطور محدودیت CPU را با Prometheus تشخیص دهیم؟
اگر متریکهای مربوط به Containerها از طریق cAdvisor جمعآوری شوند، میتوانیم وضعیت Throttling را در Prometheus بررسی کنیم.
چند Metric مهم در این زمینه عبارتاند از:
| Metric | کاربرد |
|---|---|
container_cpu_usage_seconds_total | میزان زمان مصرف CPU |
container_cpu_cfs_periods_total | تعداد دورههای CFS |
container_cpu_cfs_throttled_periods_total | تعداد دورههای دارای Throttling |
container_cpu_cfs_throttled_seconds_total | زمان تجمیعی ثبتشده برای Throttling |
البته وجود این متریکها به نسخه و تنظیمات cAdvisor، Runtime و نحوه جمعآوری Metrics بستگی دارد.
بررسی میزان مصرف CPU
برای مشاهده میانگین مصرف CPU هر Container:
sum by (namespace, pod, container) (
  rate(container_cpu_usage_seconds_total{
    container!="",
    image!=""
  }[5m])
)
خروجی برحسب تعداد Core مصرفشده است. برای مثال مقدار 0.5 معادل 500m CPU است.
محاسبه نسبت دورههای دارای محدودیت CPU (Throttled Periods)
برای محاسبه درصد دورههایی که در آنها Throttling اتفاق افتاده است:
100 *
sum by (namespace, pod, container) (
  rate(container_cpu_cfs_throttled_periods_total{
    container!="",
    image!=""
  }[5m])
)
/
clamp_min(
  sum by (namespace, pod, container) (
    rate(container_cpu_cfs_periods_total{
      container!="",
      image!=""
    }[5m])
  ),
  1e-9
)
برای مثال اگر خروجی ۳۰ درصد باشد، یعنی تقریباً ۳۰ درصد از دورههای مشاهدهشده دارای رویداد Throttling بودهاند.
اما دقت کنید: این عدد به معنی آن نیست که Container در ۳۰ درصد زمان کاملاً متوقف بوده است. فقط نشان میدهد در چه نسبتی از دورهها Throttling ثبت شده است.
برای تحلیل بهتر باید این Metric را در کنار CPU Usage و Latency خود Application بررسی کنیم.
بررسی زمان اعمال محدودیت CPU (Throttled Time)
Query زیر نرخ افزایش زمان ثبتشده برای Throttling را نشان میدهد:
sum by (namespace, pod, container) (
  rate(container_cpu_cfs_throttled_seconds_total{
    container!="",
    image!=""
  }[5m])
)
این مقدار مستقیماً معادل زمان انتظار درخواستهای Application نیست؛ بنابراین نباید آن را بهعنوان Latency سرویس تفسیر کنیم.
پیشنهاد: در Dashboard مربوط به Kubernetes، نمودارهای CPU Usage، Throttled Periods، Throttled Time و P95/P99 Latency را کنار هم قرار دهید. بررسی همزمان این نمودارها تصویر دقیقتری از وضعیت Workload به شما میدهد.
چطور مشکل محدودیت CPU را برطرف کنیم؟
اولین واکنش به مشاهده Throttling معمولاً افزایش CPU Limit است؛ اما همیشه نباید سریع سراغ این راهحل برویم.
قبل از هر تغییری باید مشخص کنیم آیا واقعاً CPU Quota عامل افت Performance است یا مشکل از جای دیگری میآید.
چند راهکار قابل بررسی وجود دارد:
۱. بازبینی محدودیت CPU (CPU Limit)
اگر Limit کمتر از نیاز واقعی Application باشد، افزایش آن میتواند Throttling را کاهش دهد.
اما Limit بیش از اندازه ممکن است باعث شود یک Workload منابع بیشتری مصرف کند و روی سایر سرویسهای همان Node اثر بگذارد.
۲. بازبینی درخواست CPU (CPU Request)
اگر مشکل ناشی از رقابت Workloadها برای استفاده از CPU باشد، Request نامناسب میتواند یکی از عوامل باشد.
افزایش Request ممکن است سهم نسبی CPU را در شرایط Contention بهبود دهد؛ اما بهتنهایی محدودیت Quota را برطرف نمیکند.
۳. بررسی مدیریت CPU (CPU Manager)
در Kubernetes قابلیتی به نام CPU Manager وجود دارد که با Policy مناسب میتواند CPU Coreهای اختصاصی را در اختیار برخی Workloadها قرار دهد.
برای مثال، در Policy نوع static، بعضی Containerها که شرایط لازم را دارند میتوانند CPU اختصاصی دریافت کنند.
این قابلیت برای Workloadهای حساس به Performance میتواند مفید باشد، اما نیازمند بررسی دقیق شرایط Pod، تنظیمات Kubelet و ظرفیت Node است.
۴. بررسی امکان استفاده از CPU Burst
Linux از مکانیزم CPU Burst هم پشتیبانی میکند که در شرایط مشخص اجازه میدهد Cgroup از Runtime ذخیرهشده برای مصرف لحظهای بیشتر استفاده کند.
اما پشتیبانی و نحوه استفاده از آن به نسخه Kernel، Cgroups و امکانات Kubernetes بستگی دارد. نباید فرض کنیم این قابلیت صرفاً با تعریف CPU Limit بهصورت خودکار فعال میشود.
۵. بررسی رفتار خود Application
گاهی مشکل از نحوه پردازش درخواستهاست؛ مثلاً تعداد Workerها بیش از حد زیاد است یا Application درگیر Lock Contention و پردازشهای غیرضروری شده است.
در چنین شرایطی افزایش CPU Limit شاید موقتاً وضعیت را بهتر کند، اما مشکل اصلی همچنان باقی میماند.
جمعبندی
CPU Throttling یکی از آن مشکلاتی است که ممکن است در نگاه اول بهسادگی قابل تشخیص نباشد.
ممکن است مصرف CPU در نمودارها طبیعی به نظر برسد، اما Container مرتباً به Quota خودش برسد و برای ادامه اجرای Threadها منتظر بماند.
برای عیبیابی درست، فقط دیدن CPU Usage کافی نیست. باید رفتار Cgroups، آمار Throttling، وضعیت CPU در Node و Latency واقعی Application را کنار هم بررسی کنیم.
در نهایت، هدف این نیست که همیشه CPU Limit را افزایش دهیم؛ هدف این است که بفهمیم محدودیت دقیقاً کجا اعمال میشود و آیا واقعاً همان محدودیت باعث افت Performance شده است یا نه.